ChatGPTなどの生成AIをビジネスで使ってみたものの、自社の商品やサービスに関する質問には的外れな回答しか返ってこない、といった経験をお持ちの経営者の方も多いのではないでしょうか。RAG(検索拡張生成)は、こうした課題を解決するための技術として近年注目を集めています。本記事では、RAGの基本的な仕組みから、社内マニュアル検索や問い合わせ対応といった具体的なビジネス活用法、導入前に整えておきたい社内データの整備状況まで、当社での知見を交えてわかりやすく解説します。
- RAGとは何かをわかりやすく教えて
- RAGの仕組み(検索+生成の2段階)
- RAGを導入するとビジネスでどう役立つ?
- 導入時の注意点(社内データの整備状況)
- RAGとAIエージェントは何が違いますか
RAGとは何かをわかりやすく教えて
RAG(Retrieval-Augmented Generation、検索拡張生成)とは、生成AIが回答を作る前に、あらかじめ用意された文書やデータベースから関連する情報を検索し、その内容をもとに回答を生成する仕組みのことです。ChatGPTのような生成AIを何も工夫せずそのまま使う場合、AIは学習時点までの一般的な知識をもとに回答しますが、自社の商品情報や社内規定、最新の在庫状況といった情報は基本的に把握していません。RAGを組み込むことで、AIは自社の文書を「参照しながら」回答できるようになり、学習データにない情報についても根拠のある回答を返せるようになります。Google Cloud「What is Retrieval-Augmented Generation (RAG)?」によれば、RAGは学習データの陳腐化や誤った情報の生成(ハルシネーション)といった大規模言語モデルの限界に対処する仕組みとされています。当社では、RAGを「生成AIに自社専用の知識を持たせるための仕組み」と説明することが多く、この理解のしやすさが、経営者の方にRAGを紹介する際にも役立っています。
RAGの仕組み(検索+生成の2段階)
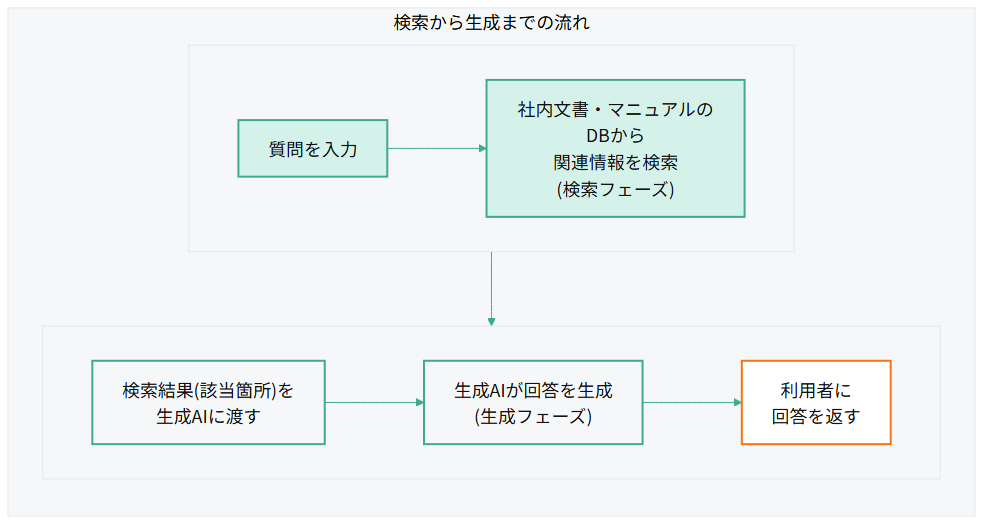
RAGは大きく分けて「検索」と「生成」という2つの段階で動作します。まず質問が入力されると、社内文書やマニュアルなどをあらかじめデータベース化して蓄積した中から、質問と関連性の高い情報を検索します。次に、検索で見つかった情報を生成AIに渡し、その情報をもとに自然な文章として回答を生成します。この2段階の仕組みがあることで、生成AIは自社固有の情報を踏まえた回答を作れるようになります。単純にAIへ社内文書を丸ごと読み込ませる方法と比べて、必要な部分だけを都度検索して渡す仕組みのため、扱う文書量が多くなっても回答の精度を保ちやすいという特徴があります。AWS(Amazon Web Services)「Understanding Retrieval Augmented Generation」でも、文書をあらかじめデータベース化したうえで関連情報を検索するフェーズと、その情報をもとに生成AIが回答を組み立てるフェーズという2段階の構造として、RAGの仕組みが説明されています。
RAGを導入するとビジネスでどう役立つ?
RAGのビジネス活用として代表的なのが、社内向けの情報検索と、社外向けの問い合わせ対応の2つの場面です。当社では、社内に蓄積された情報をどう活用するかという相談を受ける機会が増えており、その多くがこの2つのどちらかに当てはまります。
| 活用場面 | 対象データ | 主な効果 | 運用上の注意点 |
|---|---|---|---|
| 社内マニュアル検索(社内向け) | 業務マニュアル・議事録・規定集などの社内文書 | 自然な言葉で質問するだけで該当箇所にたどり着け、業務の属人化を軽減できる | 文書化されていない知識は検索対象にできない |
| 問い合わせ対応(社外向け) | 過去のFAQ・製品マニュアルなど | 担当者ごとの回答品質のばらつきを抑え、正確な一次回答を用意しやすい | 文書範囲を絞り込むほうが精度が安定しやすく、一次回答は担当者確認後に送信する |
社内マニュアル検索への活用
業務マニュアルや過去の議事録、規定集などが社内に大量に蓄積されている場合、必要な情報を探し出すだけでも一定の時間がかかります。キーワード検索では、言い回しが少し違うだけで欲しい情報にたどり着けないことも珍しくありません。RAGを導入すれば、担当者が知りたいことを自然な言葉で質問するだけで、関連する文書の該当箇所をもとにした回答が得られるようになります。ベテラン社員に聞かなければ分からなかったような細かい社内ルールも、文書として残ってさえいれば検索対象にできる点は、業務の属人化を減らすうえでも有効です。新しく入社したメンバーの自己解決にもつながります。
問い合わせ対応の精度向上
顧客からの問い合わせに対応するカスタマーサポートの場面でも、RAGは役立ちます。過去のFAQや製品マニュアルを検索対象として組み込んでおくことで、担当者ごとの回答品質のばらつきを抑えつつ、より正確な一次回答を用意しやすくなります。問い合わせ対応にRAGを組み込む場合、検索対象とする文書の範囲を絞り込んでおいたほうが、かえって回答精度が安定しやすいという傾向があります。Microsoft Learn「Develop a RAG Solution on Azure – Information-Retrieval Phase」でも、該当フィールドに対するキーワードやエンティティで検索範囲を絞り込むことがクエリ全体の性能を高め、より関連性の高い結果につながるとされています。文書を無制限に増やせばよいというものではない点は、意外と見落とされがちです。また、一次回答は担当者が内容を確認したうえで送信する運用にすると、誤った情報が届くリスクを抑えられます。一次対応の自動化やFAQ整備を含めたカスタマーサポート全体でのAI活用の進め方は「カスタマーサポートのAI活用|一次対応・FAQ自動化の実践ガイド」でも詳しく解説していますので、あわせてご覧ください。
導入時の注意点(社内データの整備状況)
RAGを導入するうえで、意外と見落とされがちなのが、検索対象となる社内データの整備状況です。RAGはあくまで「用意された文書の中から」情報を探し出す仕組みのため、社内文書がバラバラのフォーマットで保管されていたり、内容が古いまま更新されていなかったりすると、期待した精度の回答は得られません。当社では、RAG導入の相談を受けた際、まず社内文書がどの程度整理されているかを確認するところから始めるようにしています。導入を急ぐ前に、最新版と旧版が混在していないか、部署ごとに情報がバラバラになっていないかといった点を、ある程度整理しておくことをおすすめします。すべての文書を完璧に整える必要はありませんが、最低限の整理がされているかどうかで、導入後の使い勝手は大きく変わってきます。
RAG導入までの一般的な流れ
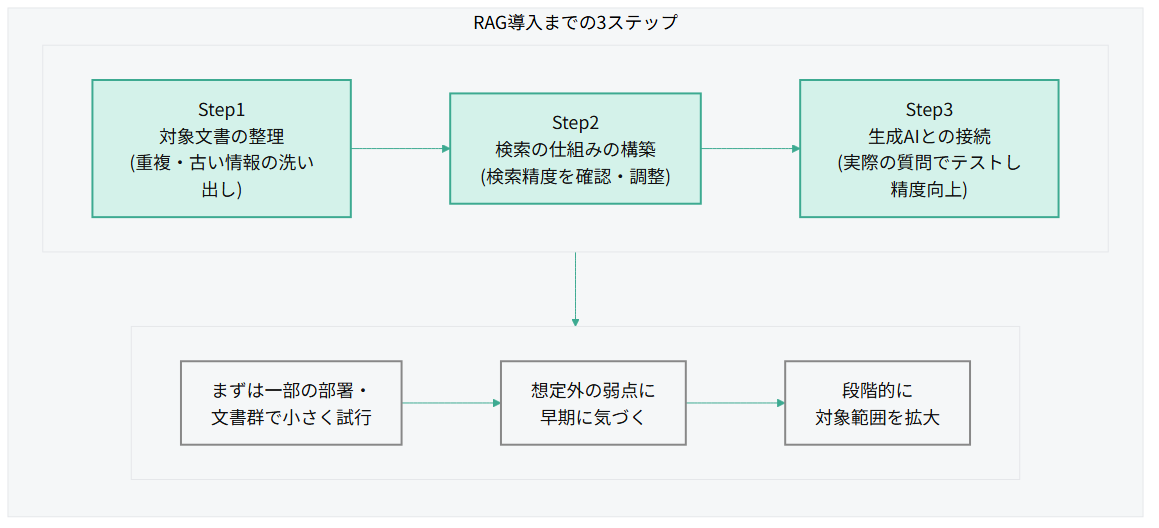
RAGの導入は、大きく「対象文書の整理」「検索の仕組みの構築」「生成AIとの接続」という3つのステップで進めることが一般的です。まず検索対象の社内文書を洗い出して重複や古い情報を整理し、次に検索しやすい形に変換して精度を確認・調整し、最後に生成AIと接続して実際の質問でテストしながら精度を高めていきます。実務の現場でよく見られる傾向として、いきなり全社的に導入するのではなく、まずは一部の部署や特定の文書群に絞って小さく試してみたほうが、想定していなかった検索の弱点に早い段階で気づきやすいとされています。当社では、こうした小さな範囲からの試行を経てから、対象範囲を段階的に広げていく進め方を提案することが多くあります。導入担当者を明確に決めておくと、検索結果の精度を継続的に確認する体制も作りやすくなります。
RAGとAIエージェントは何が違いますか
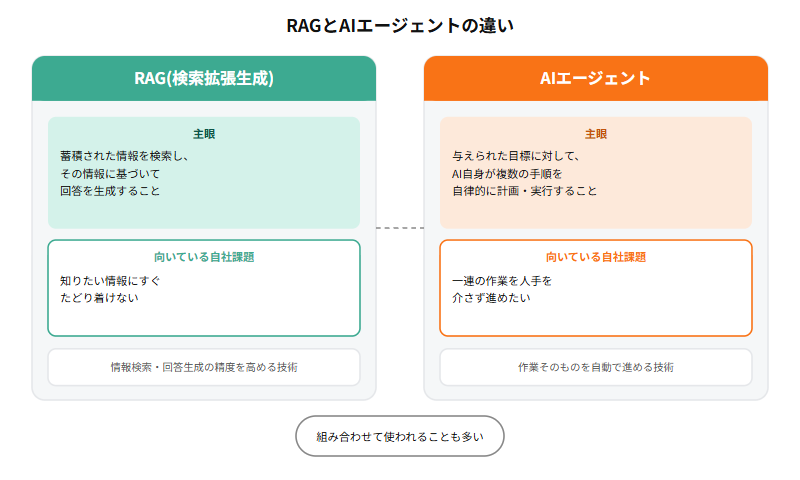
RAGと混同されやすい概念に「AIエージェント」があります。RAGが「蓄積された情報を検索し、その情報に基づいて回答を生成する」ことに主眼を置いた仕組みであるのに対し、AIエージェントは「与えられた目標に対して、AI自身が複数の手順を自律的に計画し、実行する」ことに主眼を置いた仕組みです。AWS「What is Agentic AI?」では、AIエージェント(エージェンティックAI)を、あらかじめ定められた目標を達成するために自律的に行動できるAIシステムと定義しています。両者は組み合わせて使われることも多いものの、RAGは情報検索・回答生成の精度を高める技術、AIエージェントは作業そのものを自動で進める技術という違いがあり、この違いを理解しておくと導入目的を整理しやすくなります。AIエージェントの具体的な活用場面や技術的な限界については「AIエージェントの最新動向とは|中小企業におけるビジネス活用の可能性」で詳しく解説しています。
| 項目 | RAG | AIエージェント |
|---|---|---|
| 主眼 | 蓄積された情報を検索し、その情報に基づいて回答を生成すること | 与えられた目標に対し、AI自身が複数の手順を自律的に計画・実行すること |
| 得意なこと | 社内文書・データベースを参照した根拠のある回答の生成 | 目標達成に向けた一連の作業の自動的な遂行 |
| 向いている自社課題 | 知りたい情報にすぐたどり着けない | 一連の作業を人手を介さず進めたい |
| 動作のイメージ | 質問に対して検索→生成の2段階で回答を返す | 目標に対して計画→実行を繰り返し、必要に応じて手順を修正する |
| 組み合わせ利用 | 検索した情報をもとにエージェントが作業を進める構成も可能 | RAGを情報収集の手段として組み込むことも多い |
自社の課題が「知りたい情報にすぐたどり着けない」ことであればRAG、「一連の作業を人手を介さず進めたい」ことであればAIエージェントが検討対象になる、という切り分け方が分かりやすいでしょう。両方の技術を混同したまま導入を検討してしまうと、実際に必要な仕組みとは異なるものを選んでしまう可能性もあるため、まずはどちらの課題を解決したいのかを整理しておくことが大切です。
生成AI活用の理解を広げるために
RAGの理解を深めるうえで、生成AI全般の活用方法もあわせて押さえておくと、導入イメージが具体化しやすくなります。回答品質はプロンプト次第で変わるため「生成AIによるコンテンツ制作の実践ガイド|プロンプト設計の3つのコツ」も参考になります。土台となる生成AIモデル選びも重要なため「ChatGPT・Claude・Gemini完全比較|業務別の使い分け方2026」で特徴を比較しておくとよいでしょう。検索結果に的確な指示を出す設計力も欠かせないため「プロンプトエンジニアリング基礎|ビジネス活用で押さえたい実践コツ」も参考になります。
まとめ
RAGは、生成AIに自社の文書やデータベースを検索させたうえで回答を生成させる仕組みであり、社内マニュアル検索や問い合わせ対応の精度向上といった場面で活用が広がっています。導入にあたっては、社内データがある程度整理されていることが前提になるため、まずは自社の文書がどのような状態にあるかを確認することから始めるのがおすすめです。当社では、RAG導入の相談を受ける際、業務の自動化を目指すAIエージェントとは異なる技術であることも含めてご説明するようにしています。自社データを使ったRAG活用について具体的に相談したい場合は、当社へのご相談もご検討ください。
マーケティングでお困りでしたらご相談ください
マーケティング戦略立案から実行支援まで、貴社の課題に応じた最適なプランをご提案します。まずはお気軽にご相談ください。
よくある質問
Q RAGと通常のChatGPT利用の違いは何ですか?
通常のChatGPT利用では学習時点までの一般的な知識をもとに回答しますが、RAGは自社の文書やデータベースを検索したうえで、その内容に基づいて回答を生成する点が異なります。自社に関する具体的な質問にも根拠のある回答を返しやすくなります。
Q RAGを導入するのに専門知識は必要ですか?
仕組みを構築する段階では一定の技術的な知見が必要になりますが、導入後の利用自体は自然な言葉で質問するだけで済むように設計されることが一般的です。導入方法によって必要な専門知識の度合いは変わってきます。
Q 社内データが整理されていなくても導入できますか?
導入自体は可能ですが、検索対象となる文書がバラバラのフォーマットだったり内容が古いままだったりすると、期待した精度の回答は得られにくくなります。最低限の整理をしてから導入することをおすすめします。
Q RAGとAIエージェントは何が違いますか?
RAGは蓄積された情報を検索し、その内容に基づいて回答を生成する技術です。一方でAIエージェントは、与えられた目標に対してAI自身が複数の手順を自律的に計画・実行する技術であり、主眼を置いている部分が異なります。
Q 自社データを使ったRAG活用を相談したい場合は?
自社にどのようなデータがあり、RAGでどこまで対応できそうかを整理したい場合は、当社へのご相談もご検討ください。